xAI lança Grok 4.7 com preços reduzidos e foco em programação
A xAI anunciou o Grok 4.7 para programação, cobrando US$ 2 por milhão de tokens de entrada. Testes mostram distância de rivais como o GPT-6.
Resumo rápido
- A xAI apresentou o Grok 4.7, apontado como seu modelo mais avançado para código e trabalho de conhecimento.
- O modelo é cobrado a US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída.
- Avaliações independentes mostram que o sistema ainda fica atrás de concorrentes como GPT-6 e Claude Fable 5.1.
Entenda o contexto
Modelos de linguagem utilizam tokens para processar e gerar textos ou códigos. A medição de desempenho em testes independentes permite comparar a capacidade técnica de diferentes sistemas em tarefas específicas, como a programação automatizada.
A xAI lançou o Grok 4.7, seu modelo mais capaz até o momento para tarefas de programação e trabalho de conhecimento. Segundo a empresa fundada por Elon Musk, a novidade foi desenvolvida sobre um modelo base maior, passou por um treinamento de aprendizado por reforço mais longo e foi projetada para verificar melhor as próprias respostas.
O grande diferencial do lançamento está na estrutura de custos, fixada em US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída — o termo token refere-se aos pedaços de texto ou código processados pelos sistemas. Os valores cobrados pela xAI aproximam o produto das opções chinesas e o distanciam do patamar praticado por modelos de fronteira ocidentais.
Desempenho em testes independentes revela diferença para concorrentes
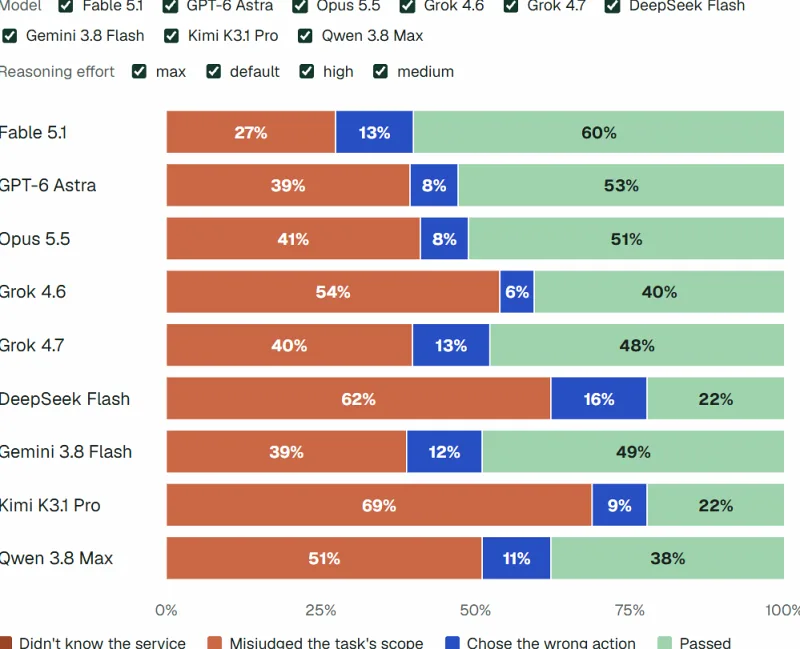
Apesar da redução nos valores, medições independentes apontam que o Grok 4.7 não atinge o mesmo desempenho de outros modelos topo de linha do mercado, como a linha GPT-6. No Artificial Analysis Intelligence Index (versão 4.3.2), avaliação que combina dez benchmarks distintos, a novidade da xAI alcançou a pontuação 46, ficando na média do setor. Nesse mesmo indicador, o Claude Fable 5.1 e o GPT-6 lideram o ranking com 53 pontos cada.
A distância aumenta nas tarefas de programação baseadas em agentes. No teste Terminal-Bench 4.0, o Grok 4.7 registrou uma taxa de acerto de 26%. O índice fica abaixo dos 60% obtidos pelo GPT-6 Astra e dos 55% alcançados pelo Claude Fable 5.1, ficando ligeiramente atrás também do DeepSeek V4.1 Flash, uma opção mais barata que marcou 27%.
A xAI informou que o Grok 4.7 já está disponível para uso por meio da Grok API, além de integração com os ambientes Cursor e Grok Build.
Referências
- Reportagem consultada: The Decoder
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!