Pesquisas sobre IAs expiram rápido com avanço de modelos, diz estudo
Segundo estudo de Stanford, 44% de 50 alegações citadas sobre LLMs já expiraram. Autores defendem documentar versões e datas de testes.
Resumo rápido
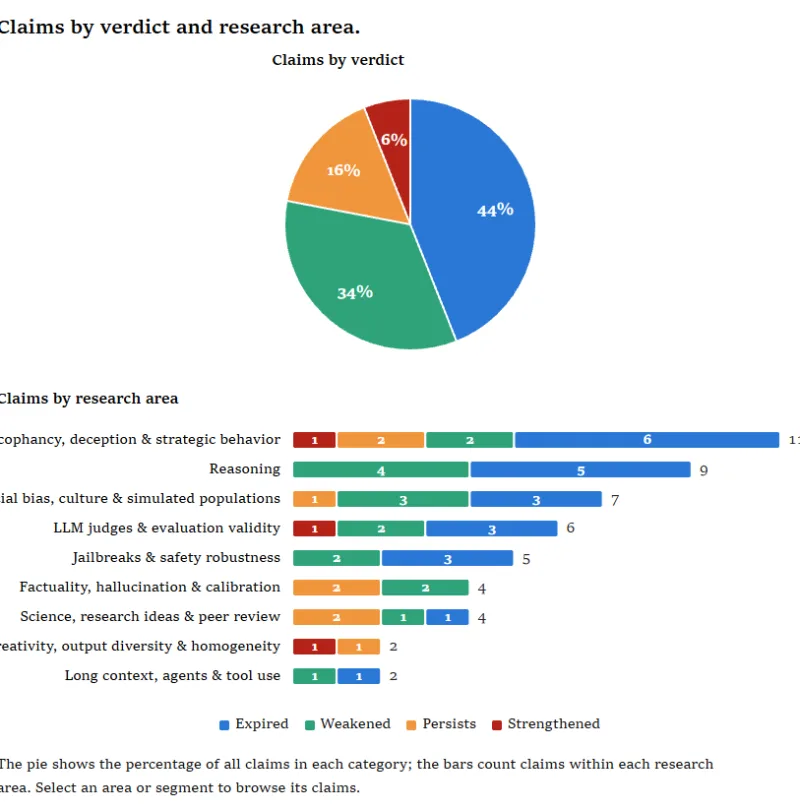
- Segundo estudo dos pesquisadores Owen Queen e James Zou, de Stanford, 44% de 50 alegações sobre LLMs já expiraram.
- Das nove constatações sobre raciocínio das IAs, pesquisadores consideram que cinco expiraram e nenhuma se manteve ou fortaleceu.
- A variação entre modelos de 2026 permanece ampla: as citações fabricadas caíram a 0% no GPT-6.1 Sol, mas alcançaram 69% no Qwen3.7-Flash.
Entenda o contexto
Grandes modelos de linguagem (LLMs) são sistemas de inteligência artificial treinados para gerar e processar linguagem natural. Como as empresas atualizam esses sistemas frequentemente, experimentos científicos sobre capacidades técnicas e limitações comportamentais podem perder a validade com o lançamento de novas versões.
Estudo de Stanford analisa validade de alegações sobre LLMs
Pesquisadores da Universidade de Stanford identificaram que a evolução rápida dos grandes modelos de linguagem (LLMs) está superando o ritmo das pesquisas acadêmicas criadas para explicá-los. Em um estudo conduzido por Owen Queen e James Zou, 50 alegações amplamente citadas na literatura científica sobre LLMs foram testadas contra 20 modelos lançados entre julho de 2024 e setembro de 2026 por oito desenvolvedores diferentes.
Segundo os autores, 44% das afirmações analisadas já expiraram, o que significa que o efeito original documentado praticamente desapareceu nos modelos mais recentes. Outros 34% dos achados enfraqueceram significativamente. Apenas 16% das alegações se mantiveram válidas e 6% ganharam força. Entre as 22 constatações para as quais foi possível estimar uma data de expiração, a vida útil média foi de 15,7 meses. O estudo registrou que, após um ano da publicação original, 16% das afirmações haviam expirado; após dois anos, essa proporção subiu para 39%.
Quais limitações de modelos expiram mais rápido?
De acordo com o levantamento dos pesquisadores de Stanford, as alegações sobre o que os modelos "não conseguem fazer" são as que perdem a validade com maior rapidez. Entre nove constatações relacionadas ao raciocínio das IAs, os pesquisadores consideram que cinco expiraram, e nenhuma se manteve totalmente ou se fortaleceu.
Essa categoria inclui falhas conhecidas em versões anteriores, como a contagem de letras em palavras específicas (a exemplo da palavra "strawberry"), cálculos aritméticos em sistemas numéricos não familiares, perda de informações no meio de contextos longos e a desistência de respostas corretas quando questionadas pelos usuários. Os pesquisadores sugerem que esses erros possuem um resultado nitidamente "correto", o que fornece aos desenvolvedores um objetivo claro de treinamento para correção.
Quais comportamentos dos modelos tendem a durar mais?
Por outro lado, as descobertas sobre preferências e tendências dos sistemas demonstraram maior durabilidade. Das 11 constatações que se mantiveram ou se fortaleceram, três envolvem o comportamento dos LLMs quando atuam como avaliadores: a preferência pelas próprias respostas, a avaliação semelhante para artigos aceitos e rejeitados, e a suscetibilidade a enquadramentos linguísticos em resumos médicos.
Outros três achados duradouros referem-se à concordância excessiva e bajulação em relação aos usuários. O estudo também apontou a permanência de um viés político inclinado à esquerda, a geração de respostas quase idênticas para perguntas abertas e uma distribuição não uniforme na geração de números aleatórios.
Como a fabricação de referências evoluiu entre as gerações?
Como estudo de caso, Queen e Zou avaliaram a fabricação de citações científicas. Em um estudo original de 2023 conduzido por Walters e Wilder, o modelo GPT-3.5 inventou 55% das referências solicitadas. Ao aplicarem os mesmos prompts aos modelos atuais, os pesquisadores constataram que o GPT-6.1 Sol inventou 0% das referências, enquanto o Claude Sonnet 5.5 registrou 1% de alucinação.
No entanto, a melhoria não foi homogênea em toda a indústria. No mesmo teste, o modelo Qwen3.7-Flash, também lançado em 2026, fabricou 69% das referências bibliográficas.
Os autores alertam que os resultados não significam a eliminação total de falhas. Em perguntas chamadas de "dois passos" (two-hop questions), em que a IA precisa combinar dois fatos conhecidos para responder, o Claude Sonnet 5.5 ainda falhou em cerca de 10% dos casos em que havia respondido corretamente a ambas as perguntas individuais. No artigo original, o ChatGPT apresentava 43% de falha nesse tipo de teste. A chamada "Maldição da Reversão" e as respostas contraditórias a pares de perguntas temporais também enfraqueceram nos modelos atuais, mas permanecem detectáveis.
Em relação a vieses sociais, os dados apresentaram um cenário misto: o viés político manteve-se, enquanto estereótipos de gênero e testes de associação implícita enfraqueceram. Vieses em relação a falantes de inglês afro-americano mudaram de direção nas tendências observadas pelos pesquisadores.
Disparidades persistem mesmo em modelos de um mesmo período
O estudo revelou grandes diferenças entre sistemas lançados na mesma época. Considerando apenas os modelos disponibilizados entre julho e setembro de 2026, o número de achados científicos expirados variou de 11 no modelo DeepSeek V4 Pro até 30 no GPT-6.1 Sol. Segundo os pesquisadores, data de lançamento, fornecedor e tamanho do modelo não servem como indicadores seguros para prever esse padrão.
Diante desses dados, Queen e Zou concluíram que achados empíricos sobre modelos de linguagem devem ser apresentados como observações relativas a modelos específicos em um momento determinado, e não como verdades gerais e permanentes. Os autores recomendam que artigos acadêmicos documentem com precisão o modelo, a versão e a data dos testes, além de publicarem os prompts e os códigos de análise para permitir a retestagem em versões futuras.
Os pesquisadores citaram ainda uma publicação de Andrej Karpathy, ex-cofundador da OpenAI que posteriormente se juntou à Anthropic, que aborda como as lacunas de percepção sobre o comportamento real dos LLMs afetam a confiança pública e a frequência de uso da tecnologia, ressaltando que os modelos disponíveis no presente são apenas uma prévia das capacidades futuras, conforme relatado no estudo veiculado pelo site The Decoder.
Referências
- Reportagem consultada: The Decoder
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!