Novo benchmark revela falhas de raciocínio em agentes de IA na nuvem
Pesquisadores criam o CloudOpsBench para testar agentes de IA em DevOps. Claude Fable 5.1 e GPT-6 Astra falham em tarefas por problemas de raciocínio.
Resumo rápido
- Pesquisadores da Universidade de Michigan apresentaram o CloudOpsBench, um benchmark de código aberto para avaliar agentes de IA em tarefas de DevOps na nuvem.
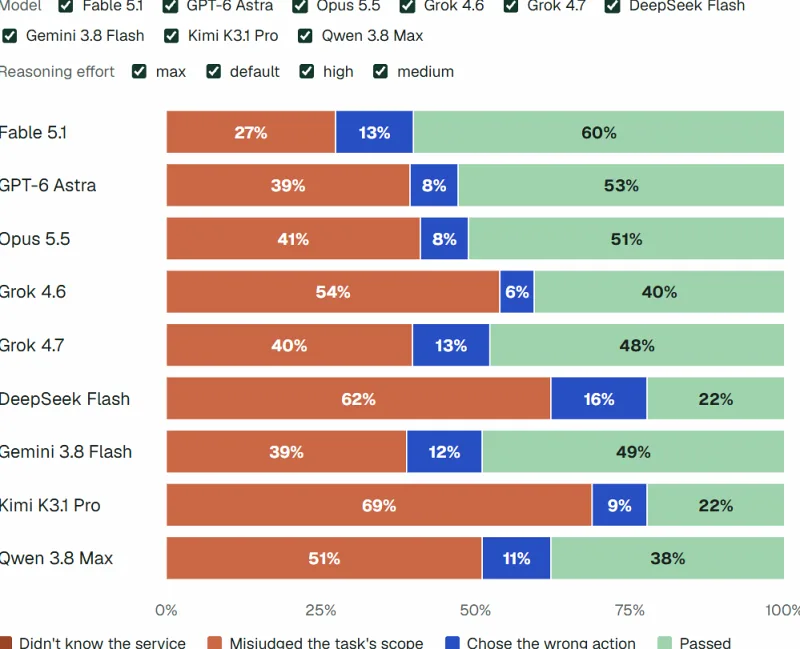
- Nos testes da versão 1.0 na AWS, o modelo Claude Fable 5.1 resolveu 60% das tarefas e o GPT-6 Astra atingiu 53%.
- Segundo a equipe do projeto, a maioria das falhas decorre da falta de raciocínio e não da falta de conhecimento dos modelos.
Entenda o contexto
O CloudOpsBench é um sistema de avaliação de código aberto projetado para medir a capacidade de agentes de IA ao realizar tarefas de gerenciamento de infraestrutura em nuvem. Segundo os pesquisadores da Universidade de Michigan, a ferramenta ajuda a identificar se os erros das IAs ocorrem por falta de dados ou por falhas de planejamento durante a execução dos processos.
Estudo avalia desempenho de agentes de IA em operações de nuvem
Uma equipe liderada por Ang Chen, da Universidade de Michigan, desenvolveu o CloudOpsBench, um novo benchmark de código aberto projetado para medir o desempenho de agentes de inteligência artificial em tarefas típicas de DevOps em ambientes de nuvem. Segundo reportagem do veículo The Decoder, a versão 1.0 do projeto foi criada por engenheiros experientes da área e engloba 45 tarefas na plataforma AWS, cobrindo desde a correção de serviços e remoção de recursos até a restrição de direitos de acesso, implantação de atualizações e desativação de projetos.
Mesmo os modelos de linguagem com melhor desempenho falharam em uma parte considerável dos testes. De acordo com os dados divulgados, o Claude Fable 5.1 conseguiu resolver 60% das tarefas propostas, enquanto o GPT-6 Astra registrou uma taxa de sucesso de 53%.
Raciocínio é o principal obstáculo no uso de IA para DevOps
Conforme a avaliação da equipe responsável pela pesquisa, o maior gargalo identificado nos agentes de IA não é a ausência de conhecimento técnico, mas sim a capacidade de raciocínio. Os pesquisadores relatam que cerca de 80% das falhas acontecem porque os sistemas julgam incorretamente o escopo da tarefa, deixam de checar todos os serviços relevantes ou interrompem a execução antes do momento adequado.
Os 20% restantes dos erros identificados no estudo correspondem a ações incorretas tomadas pelos sistemas, sendo que algumas dessas falhas provocaram consequências irreversíveis para a infraestrutura testada. As avaliações de capacidade em sistemas automatizados vêm sendo monitoradas pela indústria em diferentes frentes, como demonstrado quando a Meta atualiza agente Muse com e-mail próprio e uso do computador.
Estrutura do benchmark e expansões planejadas
Todas as 45 tarefas da versão inicial do CloudOpsBench foram executadas de forma idêntica tanto na nuvem real da AWS quanto em um ambiente de emulação. O projeto está disponível no GitHub sob a licença Apache 2.0 e inclui uma análise detalhada sobre as falhas registradas durante as medições. Os criadores informaram que preveem o lançamento de extensões futuras para suportar outras plataformas de infraestrutura, incluindo GCP, Azure e OCI.
Referências
- Reportagem consultada: The Decoder
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!