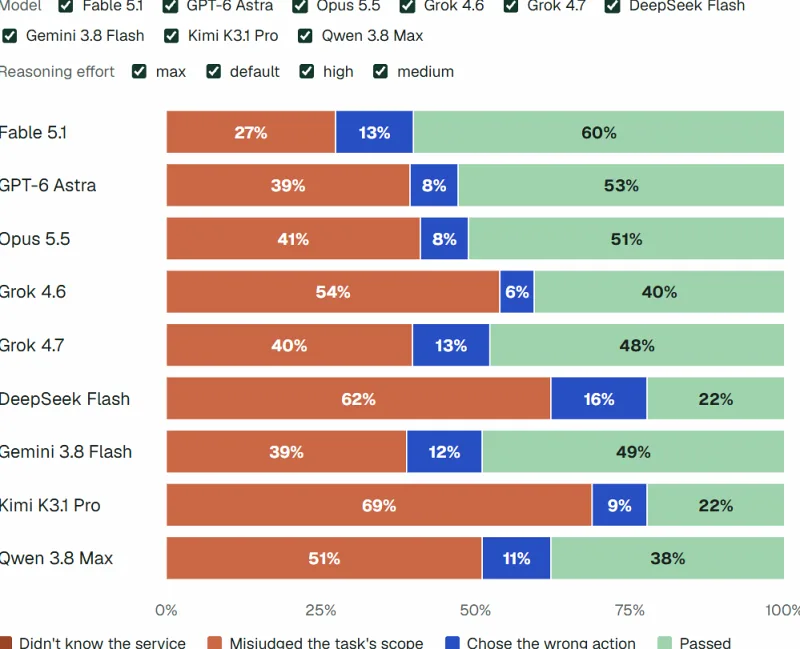
Novo benchmark revela falhas de raciocínio em agentes de IA na nuvem
Pesquisadores criam o CloudOpsBench para testar agentes de IA em DevOps. Claude Fable 5.1 e GPT-6 Astra falham em tarefas por problemas de raciocínio.
Domingo, 8 de novembro de 2026
Em alta
Tag
3 artigos
Pesquisadores criam o CloudOpsBench para testar agentes de IA em DevOps. Claude Fable 5.1 e GPT-6 Astra falham em tarefas por problemas de raciocínio.
A xAI anunciou o Grok 4.7 para programação, cobrando US$ 2 por milhão de tokens de entrada. Testes mostram distância de rivais como o GPT-6.
A Anthropic anunciou o Claude Opus 5.5, novo modelo que reduz custos operacionais, melhora a escrita e inclui restrições de segurança mais rigorosas.
Os anúncios da Adsterra já podem carregar e usar cookies ao abrir o site. Você pode aceitar ou personalizar a exibição. Saiba mais.
O Google Analytics só mede visitas após sua autorização. “Aceitar cookies” permite essa medição; “Personalizar cookies” separa as escolhas.