UBTECH apresenta o Thinker-WM, modelo que une vídeo, profundidade e ações
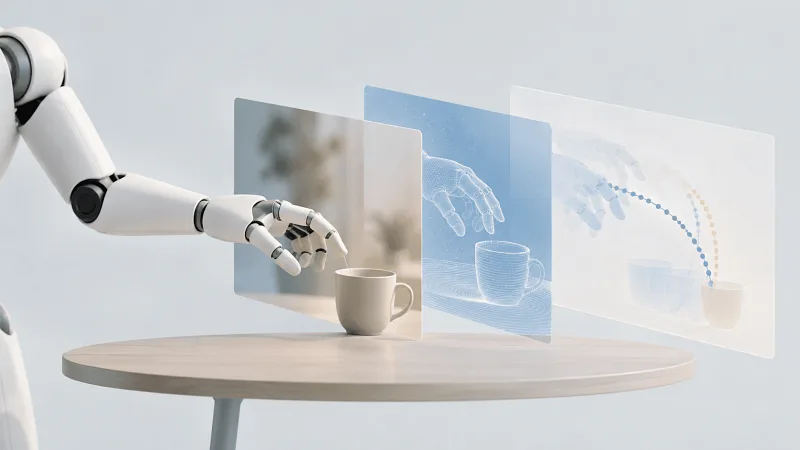
UBTECH divulga detalhes do Thinker-WM, modelo de mundo que integra vídeo RGB, profundidade métrica e ações de robô em representação compartilhada.
Resumo rápido
- UBTECH divulgou o modelo Thinker-WM que unifica vídeo, profundidade e ações de robô.
- O modelo lidera os benchmarks WorldOlympiad, EWMBench e WorldArena 1.0 Track-1.
- O treinamento envolveu cerca de 30 mil horas de vídeos, dados de robôs e simulação.
Entenda o contexto
UBTECH é uma empresa que desenvolve tecnologia robótica e apresentou o modelo Thinker-WM para unificar diferentes modalidades sensoriais e de controle em uma representação conjunta. A abordagem busca integrar vídeo, geometria de profundidade e ações de robôs em um único sistema de inteligência artificial.
A UBTECH publicou os detalhes do Thinker-WM, um modelo de mundo desenvolvido por sua equipe Thinker que codifica vídeo RGB, profundidade métrica e ações de robô em uma única representação compartilhada. Um artigo técnico sobre o projeto está disponível na plataforma arXiv.
Desempenho e benchmarks
De acordo com a empresa, o modelo ocupa a primeira posição em três benchmarks de modelos incorporados, embora essas colocações sejam alegações próprias baseadas nos resultados disponíveis no momento do anúncio. No WorldOlympiad, um benchmark baseado em dados reais de interação de robôs que abrange mais de dez corpos robóticos e diversas configurações de câmera, o Thinker-WM obteve uma pontuação geral de 0.740, além de registrar as maiores pontuações individuais para consistência 3D (0.531) e fidelidade de interação (0.765).
No EWMBench, a pontuação total reportada foi de 4.66, ficando à frente de modelos como Qwen-RobotWorld e Sora 2, com resultados de destaque em métricas de correspondência de trajetória e dinâmica. Já no WorldArena 1.0 Track-1, um benchmark de simulação, a companhia afirma ter liderado em 12 dimensões de avaliação.
Arquitetura e dados de treinamento
A justificativa de design apresentada é que muitos modelos de mundo são construídos de forma fragmentada, separando geração de vídeo, redes de políticas e módulos de previsão de geometria. O Thinker-WM mapeia cada modalidade por meio de codificadores próprios para um espaço latente comum, modelando-as em conjunto em um Unified Dynamics Transformer antes de decodificar o vídeo, os mapas de profundidade e as ações executáveis. A profundidade é tratada como saída nativa em vez de um sinal auxiliar. Em testes de tarefa única no RoboTwin, a inclusão da profundidade elevou o sucesso de manipulação em 15 pontos percentuais em comparação com uma linha de base sem ela.
O volume de dados de treinamento totaliza cerca de 30.000 horas, considerando somas aproximadas que incluem cerca de 20.000 horas de vídeos de humanos em primeira pessoa em residências, comércios e fábricas, cerca de 10.000 horas de dados reais de diversos tipos de robôs e cerca de 1.000 horas de simulação. As ações dos robôs são expressas como poses do efetor final com uma etiqueta específica para cada corpo, permitindo que diferentes máquinas compartilhem o mesmo espaço de geração por meio de um pipeline de dados chamado Data Factory.
Mais informações sobre a aplicação de robôs humanoides da UBTECH na logística podem ser encontradas em UBTECH e FAW-Volkswagen testarão robôs humanoides na logística.
Referências
- Fonte consultada: Pandaily — Tecnologia chinesa
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!