Peking University e PrimeBot apresentam HIL-UMI para coleta de dados sem braço robótico
Equipe da Peking University e PrimeBot lança HIL-UMI, método que usa uma pinça manual para coletar dados de correção em robótica, reportando maior eficiência em testes.
Resumo rápido
- Equipe da Peking University e PrimeBot lançou o método HIL-UMI, que usa uma pinça manual para coletar dados de correção em robótica.
- Em testes com quatro tarefas, HIL-UMI atingiu 94.8 de pontuação média, muito acima dos 58.0 do fine‑tuning supervisionado, segundo os autores.
- O método mostrou coleta 5,63 vezes mais rápida que o HG‑DAgger, segundo os resultados divulgados pelos autores.
Entenda o contexto
HIL-UMI é um método que mantém o operador humano no ciclo de correção, mas substitui o braço robótico por uma pinça manual, permitindo a coleta de dados em ambientes menos restritos. A eficiência maior pode facilitar a geração de dados de treinamento para robôs de manipulação.
Um grupo liderado por Hao Dong na Peking University, em parceria com a fabricante chinesa de robôs pessoais PrimeBot, divulgou um novo procedimento chamado HIL-UMI para pós‑treinamento de modelos visão‑linguagem‑ação.
Coleta de dados sem braço robótico
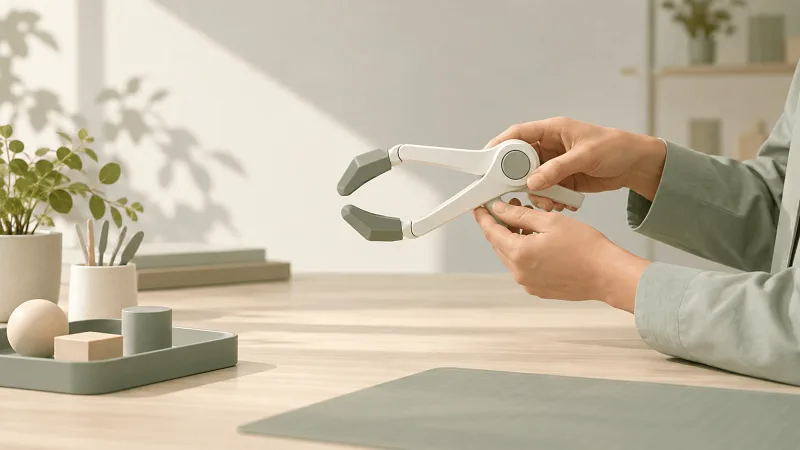
Ao contrário do tradicional HG‑DAgger, que exige que um operador assuma o controle de um braço robótico quando o modelo está prestes a falhar, o HIL‑UMI elimina o braço da etapa de coleta. O operador executa a tarefa usando uma pinça manual da Universal Manipulation Interface enquanto câmeras gravam a mesma perspectiva que a política de IA observaria.
Como o sistema orienta a coleta
Durante a gravação, a política atual prevê ações futuras. Quando um “Energy Score” indica divergência entre a distribuição de ações prevista e a trajetória humana, o sistema solicita ao operador que registre demonstrações adicionais para aquele segmento. Um segundo ciclo treina um estimador de vantagem baseado no progresso e usa clonagem comportamental condicionada à vantagem, de modo que o modelo aprenda ações que realmente avançam a tarefa.
Após cada rodada de coleta direcionada, a política é atualizada, permitindo que sessões subsequentes foquem em casos mais difíceis.
Resultados experimentais
Nos quatro experimentos reais – dobrar uma toalha, limpar uma mesa, empilhar blocos e carimbar – os autores relataram que, com o mesmo orçamento de quadros, o fine‑tuning supervisionado elevou a pontuação média de progresso de 44.3 para 58.0, enquanto o HIL‑UMI atingiu 94.8, com pontuações perfeitas nas duas tarefas de precisão.
No teste de longo horizonte de limpeza de mesa, o HIL‑UMI registrou 73.40 ms por quadro útil, comparado a 412.99 ms do HG‑DAgger, representando um ganho de eficiência de aproximadamente 5.63 vezes. Esses números são resultados apresentados pelos próprios autores e ainda não foram verificados de forma independente.
O projeto tem página dedicada em hil-umi.github.io e o artigo está disponível no arXiv.
PrimeBot já iniciou entregas de seus robôs pessoais Q1 e T1 na China; a nova abordagem pode ampliar a coleta de dados sem a necessidade de grandes laboratórios de robótica.
Referências
- Fonte consultada: Pandaily — Tecnologia chinesa
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!