Nvidia Warp e MJWarp aceleram simulacoes de robotica em GPU
Artigo detalha como o MuJoCo Warp e o Nvidia Warp executam simulações paralelas de robótica em GPUs para impulsionar o aprendizado de máquina.
Resumo rápido
- A Hugging Face e a Nvidia detalharam o uso do MJWarp para acelerar simulações de robótica diretamente em GPUs.
- O framework NVIDIA Warp permite compilar código Python em kernels CUDA de alto desempenho para processamento paralelo.
- A abordagem permite rodar até 2.048 ambientes simultâneos para treinamento e amostragem em inteligência artificial.
Entenda o contexto
O MuJoCo é um simulador de física amplamente utilizado em pesquisas de robótica para calcular movimentos, articulações e contatos. O NVIDIA Warp e o MJWarp adaptam esses cálculos para funcionarem de forma massivamente paralela em placas de vídeo (GPUs), acelerando o treinamento de modelos de inteligência artificial aplicados ao mundo físico.
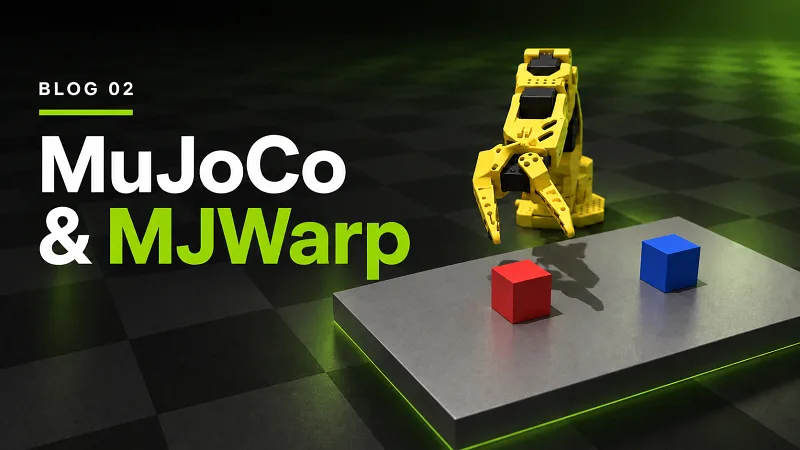
A Hugging Face detalhou, em publicação feita nesta quarta-feira, 23 de setembro de 2026, como o uso das bibliotecas NVIDIA Warp e MuJoCo Warp (MJWarp) permite migrar simulações de robótica para ambientes de processamento paralelo em grande escala em unidades de processamento gráfico (GPUs). O material faz parte da série sobre o estado da simulação para inteligência artificial física e demonstra o dimensionamento de um braço robótico SO-101 em até 2.048 ambientes paralelos.
O NVIDIA Warp é um arcabouço em linguagem Python voltado à escrita de kernels de alto desempenho. A ferramenta permite que desenvolvedores criem códigos estaticamente tipados em uma fração simplificada do Python, que são posteriormente compilados para execução nativa em CPUs ou em arquitetura CUDA da Nvidia. Na primeira execução, o sistema constrói e armazena em cache um módulo nativo que é reutilizado em chamadas subsequentes.
Processamento em lote e throughput para robótica
Enquanto o simulador MuJoCo tradicional é projetado para executar uma ou poucas instâncias de cena em processadores centrais (CPUs), o MJWarp transfere o pipeline físico do simulador diretamente para as GPUs da Nvidia. A mudança permite processar chamadas em lote por meio do comando mjw.step, avançando múltiplos cenários independentes em um único ciclo de instrução.
Segundo o texto divulgado pela Hugging Face, o ganho do MJWarp não reside necessariamente em reduzir o tempo de resposta de uma única simulação individual, mas sim no aumento do vazamento agregado (throughput) — a quantidade total de passos de simulação concluídos por segundo. Essa característica favorece fluxos de trabalho baseados em aprendizado por reforço e amostragem em larga escala, nos quais a coleta massiva de experiências é prioritária.
Recursos técnicos e otimização de desempenho
A estrutura do NVIDIA Warp traz recursos como paralelismo explícito, arrays dedicados ao dispositivo e a capacidade de encadear lançamentos de kernels gravados em gráficos CUDA para reduzir a sobrecarga do sistema. A biblioteca também oferece suporte a diferenciação para simulações físicas customizadas e, desde a versão 1.15, inclui opções de execução determinística para garantir reprodutibilidade em testes de validação.
Para otimizar o desempenho na transição de cenários do MuJoCo para o MJWarp, a publicação recomenda o ajuste rigoroso de alocações de memória de contatos e restrições, além da captura de rotinas com gráficos CUDA. As integrações para treinamento de políticas de controle de robôs podem ser feitas por meio de bibliotecas integradas como o mjlab e a plataforma MuJoCo Playground via MJX.
Referências
- Fonte consultada: Hugging Face — Blog
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!