Dharma-AI lança modelo Dharma Field Extractor para extração em JSON
Dharma-AI lança o Dharma Field Extractor para extrair campos de documentos em formato JSON e divulga resultados de benchmark.
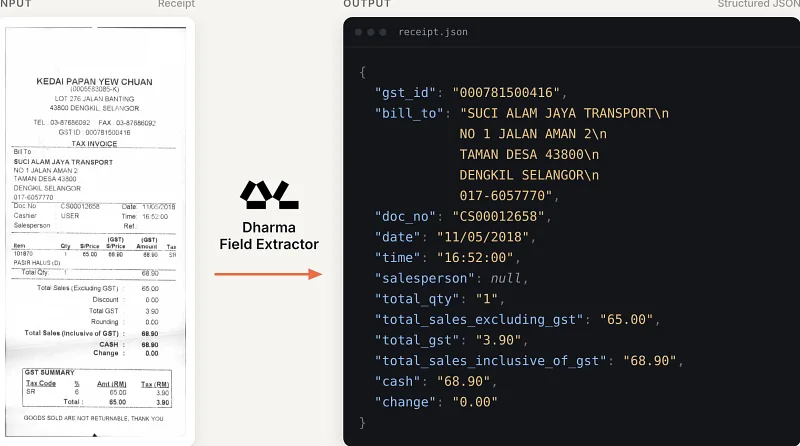
Resumo rápido
- A Dharma-AI anunciou o Dharma Field Extractor, projetado para extrair campos estruturados em JSON a partir de documentos.
- O modelo base DharmaOCR-LITE v1.1 recebeu um adaptador LoRA treinado com 43.384 exemplos de treinamento.
- Segundo a empresa, o modelo atingiu nota 0,834 em benchmark próprio de 546 documentos, superando as medições relatas para o Claude Opus 5 e GPT-5.6 Luna.
Entenda o contexto
O Dharma Field Extractor é um modelo de linguagem voltado para a extração de dados estruturados em formato JSON a partir de documentos. O artigo aborda a utilização de modelos menores focados em tarefas específicas em comparação ao uso de modelos genéricos.
A Dharma-AI publicou nesta quarta-feira, 4 de novembro de 2026, no blog do Hugging Face, os detalhes do Dharma Field Extractor. Trata-se de um modelo especializado de 2 bilhões de parâmetros desenvolvido para extrair campos específicos de documentos em formato JSON estruturado a partir de imagens de arquivos como faturas, notas fiscais, recibos, formulários e documentos de identidade.
Modos de extração e funcionamento
Segundo a publicação da empresa, enquanto ferramentas tradicionais de reconhecimento óptico de caracteres (OCR) retornam todo o texto impresso de uma página sem categorizar quais dados correspondem a cada informação, o novo modelo converte os valores diretamente para um formato de dados tipados, como texto, números ou valores booleanos (verdadeiro ou falso).
O modelo permite duas formas de solicitação de dados:
- Aberto (sem esquema): a inteligência artificial analisa o documento e identifica os pares de chave e valor a partir do contexto e da disposição visual na página, sem depender de uma lista fixa de nomes de campos.
- Direcionado por esquema: o usuário especifica a estrutura exata e o tipo de cada campo desejado utilizando os nomes de chaves do seu próprio sistema. Caso a informação solicitada não esteja presente no documento, o modelo retorna o valor nulo (null) em vez de gerar um dado inexistente.
A arquitetura utiliza como modelo base o DharmaOCR-LITE v1.1, uma versão de 2 bilhões de parâmetros otimizada a partir de trabalhos anteriores da equipe e especializada em OCR via ajuste fino supervisionado e otimização por preferência direta (DPO). Sobre essa base, a equipe treinou um adaptador LoRA utilizando 43.384 exemplos de treinamento anotados no nível de campo, cobrindo recibos, faturas comerciais, formulários, extratos bancários, documentos de identidade e documentos sintéticos.
Avaliação em benchmark e custos informados
A publicação detalha que a avaliação do modelo foi feita em um benchmark de 546 documentos em três cenários de requisição (sem esquema, com esquema parcial e com esquema contendo campos inexistentes), somando 1.638 casos de teste. A pontuação combinou a métrica F1 no nível de campo, a similaridade de Levenshtein nos valores correspondentes e a proporção de saídas em JSON válido.
De acordo com os testes divulgados pela Dharma-AI no artigo:
- Dharma Field Extractor: obteve pontuação 0,834 executando em uma única GPU L40S.
- Claude Opus 5: alcançou a pontuação 0,816 no mesmo benchmark.
- GPT-5.6 Luna: atingiu a pontuação 0,741 na mesma avaliação.
A empresa informou que os conjuntos de dados públicos SROIE (composto por recibos) e FUNSD (formulários) foram mantidos fora do treinamento e utilizados apenas na avaliação. Em um dos testes descritos com o FUNSD, o modelo identificou uma opção marcada em um formulário de verificação e retornou o valor correto para campos em branco e anotações manuscritas.
Sobre a operação, a Dharma-AI declarou que os custos de implantação própria dependem do hardware, volume e latência de cada infraestrutura. A empresa afirmou que a execução local apresentou um custo por extração de 6 a 147 vezes menor do que as APIs comerciais incluídas no benchmark da própria medição, defendendo a premissa de que modelos menores especializados em tarefas delimitadas podem superar modelos genéricos nessas funções específicas.
Referências
- Fonte consultada: Hugging Face — Blog
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!