Hugging Face detalha o Phonon, IA de voz local para dispositivos
Hugging Face apresenta detalhes do Phonon, modelo de conversão de texto em fala que roda diretamente no dispositivo e atingiu 200 mil downloads.
Resumo rápido
- A Hugging Face apresentou detalhes sobre o desenvolvimento e desempenho do Phonon, modelo de voz local lançado duas semanas antes.
- O Phonon 31m é distribuído sob licença Apache 2.0 para uso comercial, enquanto a versão Phonon 40m utiliza licença não comercial.
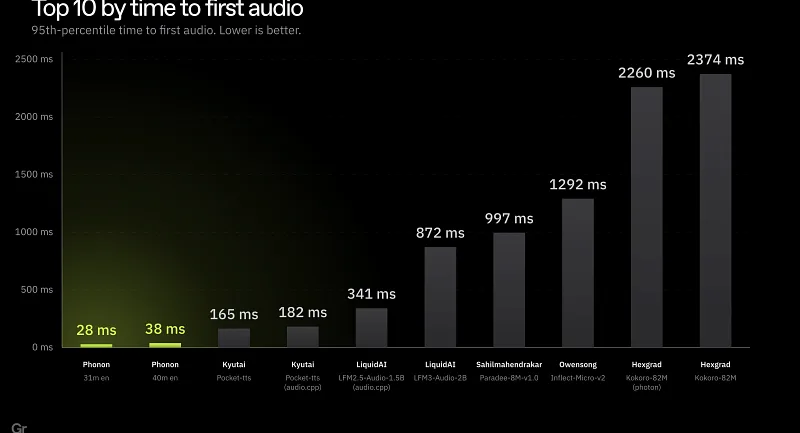
- Segundo a empresa, o projeto ultrapassou 200 mil downloads e alcançou os primeiros lugares em testes de inteligibilidade e velocidade de CPU.
Entenda o contexto
Entenda o contexto: O Phonon é uma solução de conversão de texto em fala voltada para inferência local, sem necessidade de servidores em nuvem. A disponibilização de modelos leves permite a execução de inteligência artificial em dispositivos com limitação de memória e processamento. O Open TTS Leaderboard é a tabela classificatória da Hugging Face destinada a comparar a qualidade de modelos de áudio abertos.
A plataforma Hugging Face publicou em seu blog detalhes sobre o lançamento e o funcionamento do Phonon, seu modelo de conversão de texto em fala (TTS, na sigla em inglês) projetado para ser executado diretamente em dispositivos do próprio usuário. Segundo a empresa, a solução não requer conexão com a internet nem processamento em servidores externos, mantendo os dados digitados armazenados localmente.
O modelo teve os pesos abertos duas semanas antes do relato e acumulou mais de 200 mil downloads no período. De acordo com a publicação, o projeto busca resolver um desafio histórico da sintese de voz em dispositivos menores: o equilíbrio entre o tamanho do modelo e a qualidade do áudio gerado.
Modelos, tamanhos e licenças de uso
O Phonon é derivado da linhagem Pocket TTS e utiliza a técnica de flow matching para gerar áudio. A empresa informou que o treinamento inicial apresentou instabilidade numérica, exigindo ajustes técnicos para garantir resultados nos cinco idiomas suportados: inglês, francês, alemão, espanhol e português.
O sistema foi disponibilizado em duas variações de tamanho:
- Phonon 31m: possui cerca de 65 MB, fala inglês e está disponível sob a licença código aberto Apache 2.0, permitindo o uso gratuito para fins pessoais ou comerciais.
- Phonon 40m: possui cerca de 75 MB, oferece suporte aos cinco idiomas citados e é distribuído sob a licença CC BY-NC, destinada a projetos não comerciais.
Para o modelo de 40 milhões de parâmetros, a Hugging Face informou que o licenciamento para aplicações comerciais é baseado no número de usuários da ferramenta, e não no volume de áudio gerado.
Desempenho nos benchmarks do Open TTS Leaderboard
No recém-criado Hugging Face lança Open TTS Leaderboard para avaliar modelos de voz, a empresa avaliou a arquitetura em relação a outros modelos públicos. A avaliação mede inteligibilidade por meio da taxa de erro de palavras, velocidade de processamento e naturalidade da voz.
De acordo com os dados apresentados pela Hugging Face, o Phonon alcançou:
- O primeiro lugar em inteligibilidade nas línguas alemã e espanhola.
- Posição entre os três melhores em todos os idiomas avaliados na plataforma.
- A liderança no benchmark de transmissão via CPU na métrica de tempo até o primeiro áudio emitido.
A publicação ressalta que o modelo obteve estes resultados competindo com arquiteturas que chegam a ser até 100 vezes maiores.
Execução em múltiplos ambientes e integrações
O Phonon foi desenvolvido para rodar em celulares, notebooks, computadores de placa única e navegadores web. Para garantir a execução local em diferentes hardwares, a equipe desenvolveu a estrutura de inferência ptts, que oferece suporte a mais de dez motores de execução (backends), variando entre CPUs (Intel, Arm, WebAssembly), GPUs (CUDA, Vulkan, Metal, WebGPU) e NPUs (Apple Core ML e Snapdragon).
Além da estrutura focada em dispositivo único, o modelo foi integrado à biblioteca Transformers a partir da versão v5.21. A implementação de referência em PyTorch foi desenhada para focar no rendimento de processamento em lote via GPU, permitindo a síntese de grandes conjuntos de dados de voz.
Entre as demonstrações criadas durante o lançamento estão o funcionamento em relógios Apple Watch sem Wi-Fi ativado, contagem de exercícios em iPhones sem sinal de rede e interações narratórias em jogos ou simuladores de rádio direto no navegador. A Hugging Face afirmou ainda que permite a criação de vozes personalizadas ou clonagem a partir de áudios curtos mediante autorização expressa do locutor, mantendo o arquivo de voz processado localmente no dispositivo.
Referências
- Fonte consultada: Hugging Face — Blog
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!