Olmo-core 3 é lançado com infraestrutura para treinar modelos MoE
A nova versão da infraestrutura traz suporte a modelos MoE na escala de trilhões de parâmetros e otimizações de desempenho em GPUs NVIDIA.
Resumo rápido
- Olmo-core 3 reformula sistema de treinamento para modelos do tipo Mixture-of-Experts (MoE) em grande escala.
- Adoção do paralelismo DDP e formato MXFP8 aumentou a vazão e reduziu o uso de memória em testes com GPUs NVIDIA B300.
- Framework foi avaliado em simulações que atingiram até 2,38 trilhões de parâmetros no total.
Entenda o contexto
Modelos Mixture-of-Experts (MoE) são arquiteturas de inteligência artificial que dividem a rede em subredes especializadas, ativando apenas parte do sistema para cada dado processado. O Olmo-core 3 é a infraestrutura aberta de treinamento desenvolvida para dar suporte aos modelos da família Olmo.
Foi anunciado em 1 de outubro de 2026 o lançamento do Olmo-core 3, uma atualização significativa no framework de desenvolvimento de modelos de linguagem que introduz um sistema aberto e reformulado para o treinamento de arquiteturas do tipo Mixture-of-Experts (MoE). A nova versão busca permitir o dimensionamento do treinamento na escala de trilhões de parâmetros, mantendo a eficiência computacional durante o processo.
Mudança de arquitetura e ganhos de desempenho
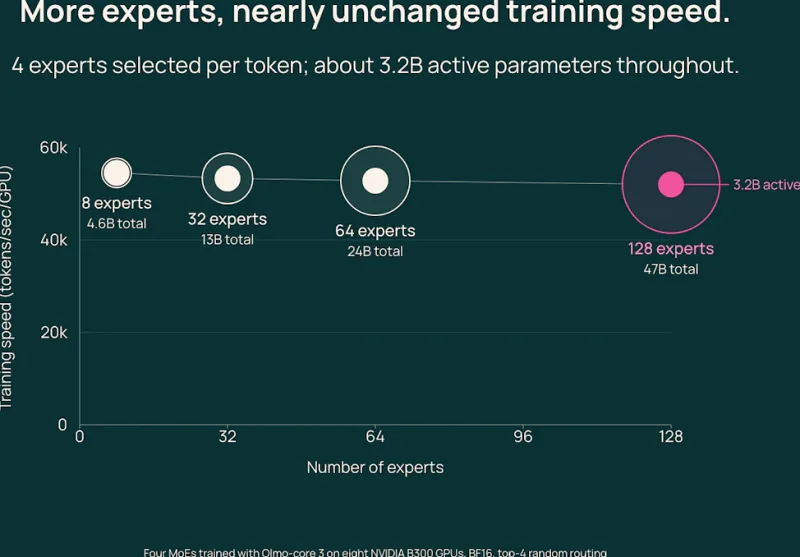
Modelos MoE utilizam componentes especializados, chamados de especialistas, permitindo aumentar a quantidade total de parâmetros sem exigir que cada entrada acione a rede inteira. No entanto, o direcionamento dos dados entre GPUs em um cluster gera custos de comunicação. O Olmo-core 3 foi projetado para mitigar esses gargalos. Em um dos testes descritos, o número de especialistas foi ampliado de 8 para 128, mantendo quatro especialistas ativos por token (cerca de 3,2 bilhões de parâmetros ativos por token). Nessa configuração, a capacidade total saltou de 4,6 bilhões para 47 bilhões de parâmetros, enquanto a queda na vazão de treinamento ficou abaixo de 5%.
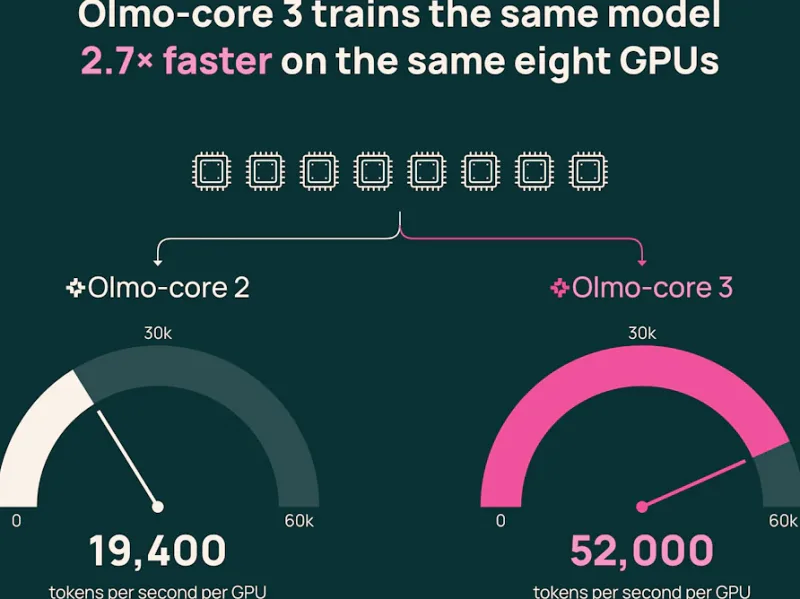
Diferentemente da versão anterior, que utilizava paralelismo de dados totalmente fragmentado (FSDP) e exigia a reunião repetida dos pesos do modelo, o Olmo-core 3 adota o paralelismo de dados distribuído (DDP). A nova abordagem mantém os especialistas residentes nas GPUs e faz o roteamento dos dados até eles. Em testes preliminares com oito GPUs NVIDIA B300, um modelo MoE de 47 bilhões de parâmetros alcançou a marca de 52.000 tokens por segundo por GPU, superando o desempenho de 19.400 tokens por segundo obtido na implementação FSDP anterior — um aumento de cerca de 2,7 vezes na vazão.
Otimizações e testes em escala de trilhões
O framework combina diferentes técnicas de distribuição, como paralelismo de especialistas, paralelismo de pipeline e otimizador distribuído. Para reduzir custos operacionais, o sistema emprega roteamento residente na GPU e suporte ao formato numérico de menor precisão MXFP8. Em um benchmark controlado com quatro GPUs NVIDIA B300, o uso de MXFP8 aumentou a vazão de treinamento em aproximadamente 21% em comparação ao baseline em BF16, além de reduzir o pico de memória ativa de 103 GiB para 95 GiB.
A infraestrutura também foi avaliada em configurações de grande porte. Em testes com 512 GPUs NVIDIA B300, o sistema operou com um modelo de 1,2 trilhão de parâmetros (sendo 58,36 bilhões ativos por token), registrando uma vazão máxima observada de 858 TFLOP/s por GPU. Em outro experimento com a tecnologia DeepEP v2, foi testada uma configuração com capacidade total de 2,38 trilhões de parâmetros. Segundo o relatório técnico, essas medições utilizaram roteamento aleatório para avaliar a capacidade do sistema, e não a qualidade final de um modelo treinado.
Para mais iniciativas relacionadas ao ecossistema da plataforma, é possível acompanhar como a Hugging Face lança Open TTS Leaderboard para avaliar modelos de voz.
Imagens
Referências
- Fonte consultada: Hugging Face — Blog
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!