NaiveAI lança modelo de pesos abertos Naive-N0.5-Flash no Hugging Face
NaiveAI lança o modelo Naive-N0.5-Flash no Hugging Face com 309B de parâmetros, licença MIT e janela de contexto de 1 milhão de tokens.
Resumo rápido
- NaiveAI lança o modelo Naive-N0.5-Flash com pesos abertos sob a licença MIT no Hugging Face.
- O modelo tem 309 bilhões de parâmetros totais e contexto nativo para 1 milhão de tokens.
- Desenvolvedores alegam velocidade de até 2.000 tokens por segundo no modo Ultrafast.
Entenda o contexto
Modelos de mistura de especialistas (MoE) ativam apenas uma fração de seus parâmetros por tarefa, otimizando o uso computacional. Já a janela de contexto de 1 milhão de tokens permite analisar grandes volumes de código ou documentos extensos simultaneamente.
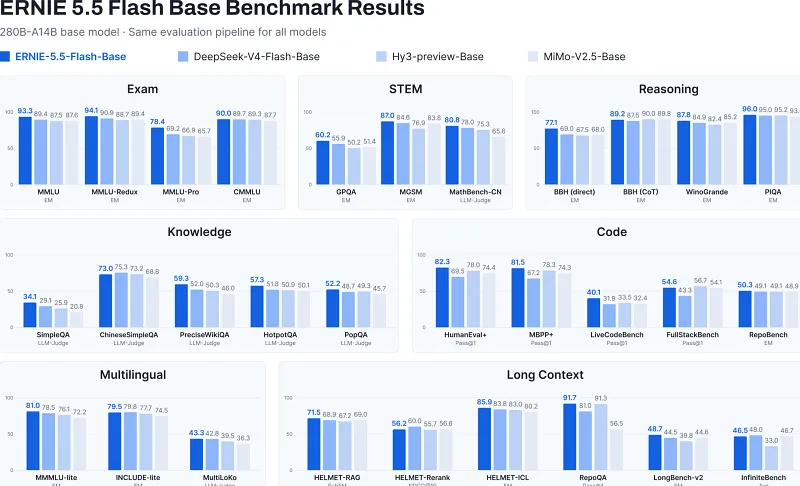
A NaiveAI disponibilizou no Hugging Face o modelo de linguagem Naive-N0.5-Flash, uma opção de pesos abertos desenvolvida para tarefas de programação e pesquisa em inteligência artificial. Lançado sob a licença MIT, o sistema utiliza uma arquitetura de mistura de especialistas (MoE) e conta com código de inferência e pesos totalmente liberados para a comunidade.
Em termos de especificações técnicas, o Naive-N0.5-Flash possui cerca de 309 bilhões de parâmetros totais, dos quais 15,5 bilhões são ativados durante o processamento. O modelo foi construído a partir da base aberta MiMo-V2.5, passando por fases intermediárias e finais de treinamento (mid-training e post-training) focadas no desenvolvimento de agentes e fluxos de trabalho voltados a código.
Arquitetura híbrida e desempenho de inferência
O grande destaque da arquitetura é sua janela de contexto nativa de 1 milhão de tokens — recurso que define a quantidade de texto que o sistema consegue processar de uma só vez. Essa capacidade é sustentada por um arranjo híbrido entre a atenção de janela deslizante (Sliding-Window Attention ou SWA) e a atenção esparsa (DeepSeek Sparse Attention ou DSA), combinadas com atenção por consulta agrupada em uma proporção aproximada de 5 para 1, sem camadas de atenção total mantidas na estrutura.
Para a execução do modelo, a NaiveAI apresentou a pilha de inferência NaiveRT, desenvolvida com técnicas de fusão de mega-kernels e decodificação especulativa. A empresa afirma que a ferramenta entrega cerca de 50 tokens por segundo por usuário no modo padrão e pode atingir até 2.000 tokens por segundo no modo Ultrafast. Como esses números são alegações do próprio fornecedor, eles dependem de verificação por testes independentes de benchmark.
Referências
- Fonte consultada: Pandaily — Tecnologia chinesa
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!