MiniMax lança modelo M3.1 Flash com foco em raciocínio e custo menor
MiniMax apresenta o M3.1 Flash, novo modelo de raciocínio que traz melhorias em testes e custos reduzidos por tarefa, com pesos abertos previstos para outubro.
Resumo rápido
- MiniMax lançou o modelo M3.1 Flash, que pontua 42 no Artificial Analysis Intelligence Index.
- O modelo traz melhorias em raciocínio complexo e consome menos tokens de saída por tarefa.
- A empresa planeja disponibilizar os pesos do modelo em 23 de outubro.
Entenda o contexto
MiniMax é uma empresa que desenvolve inteligência artificial e grandes modelos de linguagem. O termo open weights refere-se à disponibilização pública dos pesos computacionais de um modelo para utilização por terceiros.
A empresa MiniMax lançou o M3.1 Flash, um novo modelo de raciocínio que alcança 42 pontos no Artificial Analysis Intelligence Index. O valor representa uma pontuação 13 pontos superior à do seu antecessor M3, com um custo reduzido por tarefa, segundo as informações divulgadas.
Desempenho e testes
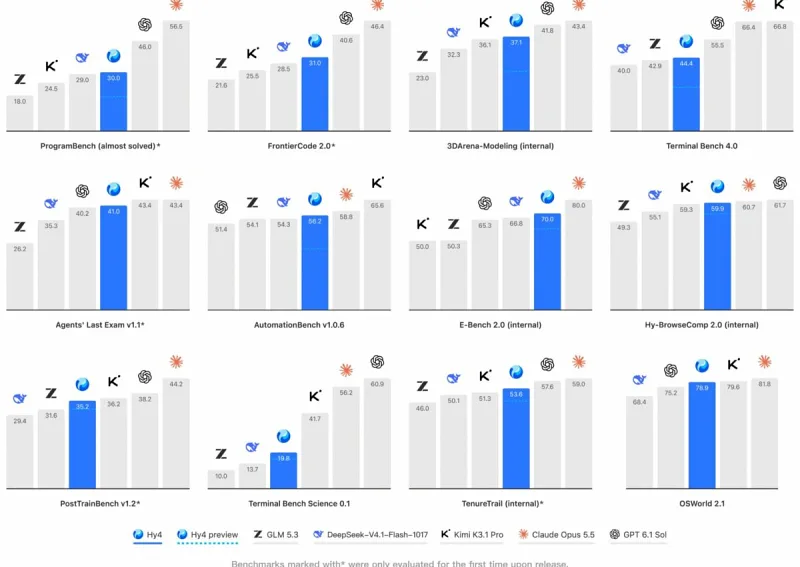
Nas avaliações de raciocínio complexo, o modelo atinge 48 por cento no teste "Humanity's Last Exam", superando concorrentes como Deepseek e GLM. No benchmark CritPt, que avalia raciocínio de física em nível de pesquisa por meio de 71 problemas complexos, o M3.1 Flash registra 22 por cento de acerto, ficando atrás do Deepseek, que atinge 24 por cento, mas à frente de outras alternativas. Em termos de precisão factual no teste AA-Omniscience, o modelo acerta 56 por cento das perguntas.
Em comparação direta com o Deepseek V4.1 Flash 1017, os resultados dividem-se entre os quesitos avaliados. O Deepseek lidera na pontuação geral do Intelligence Index e no benchmark CritPt, enquanto o M3.1 Flash obtém melhores marcas no "Humanity's Last Exam" e na precisão factual do AA-Omniscience.
Disponibilidade e custos
O M3.1 Flash lida com até um milhão de tokens de contexto, aceitando entradas de texto e imagens. O modelo consome menos tokens de saída do que os rivais, situando o custo por tarefa em cerca de US$ 0,22, conforme dados de testes. A API está disponível na plataforma da desenvolvedora, com cobranças de US$ 0,15 por milhão de tokens de entrada e US$ 0,60 por milhão de tokens de saída, além de entradas em cache a US$ 0,015. A MiniMax informou que planeja liberar os pesos do modelo em 23 de outubro.
Referências
- Reportagem consultada: The Decoder
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!