EMem-Bench avalia memória de agentes de IA incorporados
Zhejiang University lança EMem-Bench para avaliar memória de agentes de IA incorporados; Gemini-3-Flash lidera com 64,2% de acerto em simulação.
Resumo rápido
- Zhejiang University divulgou o benchmark EMem-Bench para testar memória de agentes de IA incorporados.
- Gemini-3-Flash obteve 64,2% de sucesso, enquanto modelos abertos ficaram abaixo de 45% em média.
- O sistema EMem, com GPT-5.4-mini, aumentou a taxa de sucesso para 58,9% em simulação.
Entenda o contexto
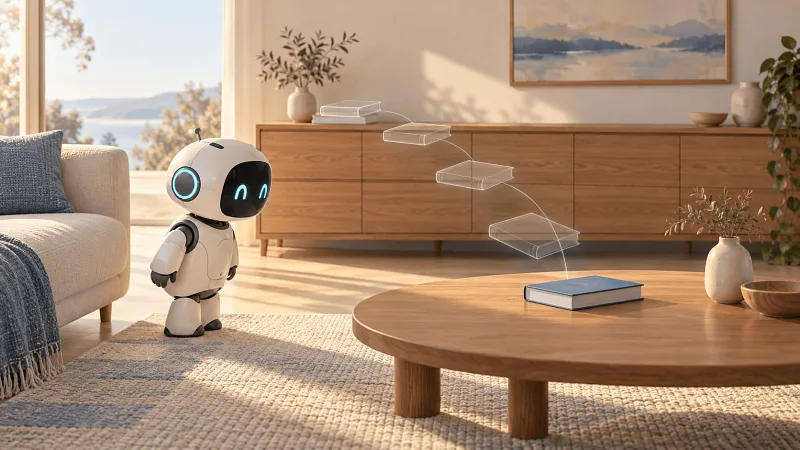
O EMem-Bench mede a capacidade de agentes de IA incorporados de lembrar e reutilizar informações de interações passadas, um desafio central para robôs domésticos que precisam operar em ambientes dinâmicos.
Um grupo do OmniAI Group, vinculado à Zhejiang University, lançou o EmbodiedMemory-Bench (EMem-Bench), um benchmark que verifica se agentes de IA incorporados conseguem construir memória a partir de longas interações e utilizá‑la para executar tarefas.
Estrutura do benchmark
O conjunto contém 2.554 episódios executáveis, cada um oferecendo um histórico multimodal ordenado no tempo seguido de um novo objetivo. Os agentes precisam recuperar evidências relevantes e, em simulação, navegar, abrir recipientes, pegar e colocar objetos até alcançar o estado desejado. As cenas do AI2-THOR de um cômodo foram combinadas em casas de múltiplos cômodos, com interações distrativas inseridas entre a pista chave e a tarefa.
Desempenho dos modelos
No cenário de contexto completo, o modelo proprietário Gemini-3-Flash liderou com taxa média de sucesso de 64,2%, seguido por Gemini-2.5-Pro (60,8%), Qwen3.6-27B (58,2%) e GPT-5.4 (56,8%). Todos os modelos de código aberto avaliados ficaram abaixo de 45%.
Os autores também apresentaram o Embodied‑Memorizer (EMem), um sistema de memória externa que separa a experiência em memórias de cena, espacial e de evento. Usando o GPT-5.4‑mini como base, o EMem elevou a taxa média de sucesso de 35,3% para 58,9%, superando o próximo melhor sistema, TeleMem, em 21,1 pontos. Uma versão afinada de 8 B (EMem‑8B) alcançou 46,0% de sucesso, 20,6 pontos acima de seu modelo base Qwen3‑VL‑8B.
Fornecer mais imagens históricas não melhorou o desempenho: a taxa de sucesso caiu de 36,6% para 26,2% enquanto os tokens de entrada por episódio aumentaram de 41.770 para 206.489.
O benchmark já recebeu mais de 32 mil downloads no Hugging Face até 18 de outubro e, segundo os autores, ainda precisa ser validado em robôs reais, que enfrentam ruído de sensores e erros de execução.
Referências
- Fonte consultada: Pandaily — Tecnologia chinesa
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!