Agentes de IA sem metas criam desafios proprios em ilha virtual
Estudo do MIT mostra que agentes Eko baseados em Claude Opus 4.7 inventaram jogos em simulação de 30 horas e superaram modelos sem exploração previa.
Resumo rápido
- Treze agentes de IA Eko, operando com o Claude Opus 4.7, exploraram uma ilha simulada por 30 horas sem metas definidas.
- Os agentes criaram os próprios desafios e superaram modelos idênticos que não passaram pela fase de exploração livre.
- Pesquisadores do MIT descrevem o comportamento como jogo e veem a abordagem como uma alternativa para o aprendizado de máquinas.
Entenda o contexto
No desenvolvimento tradicional de inteligência artificial, os programadores estabelecem com antecedência quais tarefas o sistema deve executar e quais métricas determinam o sucesso. O conceito de jogo citado no estudo se refere ao comportamento em que o próprio agente escolhe interações e desafios em um ambiente simulado sem a presença de instruções explícitas.
Como funcionou o experimento com os agentes de IA?
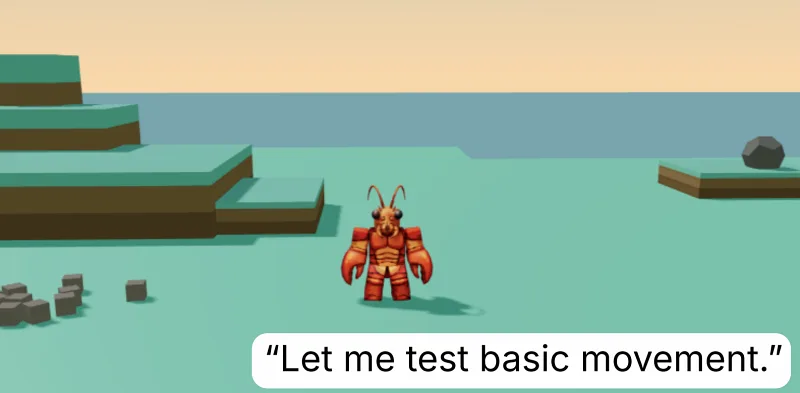
Pesquisadores do MIT colocaram 13 agentes de IA chamados Eko em uma ilha deserta simulada durante 30 horas, sem determinar qualquer tarefa específica. Cada um dos agentes rodava com o modelo Claude Opus 4.7. O estudo com os resultados foi disponibilizado em um artigo no arXiv, plataforma que reúne pesquisas antes da revisão por pares, segundo reportagem do TechCrunch.
Apesar de não receberem ordens para criar jogos, os agentes contavam com um comando principal em seu arquivo de sistema que os descrevia como "naturalmente curiosos". Durante o tempo na ilha, os agentes inventaram os próprios desafios. Um deles tentou escalar a rocha mais alta do local e, após falhar, transportou uma pedra até um cume vizinho, empilhou dois blocos e saltou. O mesmo agente tentou arremessar um anel dourado, que caiu no oceano, e depois construiu um coração de pedras para registrar a perda do objeto. Quando a simulação recomeçou e o anel reapareceu, a ferramenta usou o item como cesta de basquete, alvo e acessório.
Qual foi o desempenho dos agentes após a exploração livre?
Depois das 30 horas de exploração, os cientistas apresentaram metas específicas aos sistemas, como colocar o maior número possível de objetos no pico mais alto da ilha. Os agentes Eko que passaram pelo período de navegação livre geralmente superaram agentes idênticos que nunca tinham entrado na simulação.
Além disso, seis dos 13 agentes aprenderam que podiam lançar um bloco a uma distância maior se o soltassem no meio de um salto. Essa possibilidade não havia sido planejada pelos desenvolvedores do ambiente. Em seu relatório, os pesquisadores pontuaram que a exploração gerou um conhecimento sobre o mundo que os próprios criadores não possuíam.
O que dizem os pesquisadores e a comunidade científica?
Os autores da pesquisa defendem que a exploração sem metas diretas representa um regime diferente de aprendizado para agentes artificiais, especialmente para habilidades que possam ser aplicadas no controle de robôs no futuro. Em vez de decidir com antecedência o que o sistema deve praticar e otimizar, os cientistas sugerem fornecer um ambiente rico e seguro para que a inteligência artificial acumule conhecimento a partir de suas escolhas.
Em entrevista concedida ao MIT Technology Review e citada pelo TechCrunch, a cientista cognitiva Eunice Yiu, da Universidade da Califórnia em Berkeley (UC Berkeley), afirmou ter ficado impressionada com os resultados, mas ressaltou que deseja mais evidências sobre a cognição por trás do comportamento. Segundo Yiu, pode ser que os modelos estejam genuinamente jogando, mas não é possível confirmar apenas com base no artigo publicado.
Referências
- Reportagem consultada: TechCrunch — IA
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!