Agentes de IA criam cenas 3D a partir de fotos mas falham ao avaliar precisao
Estudo da Universidade de Maryland e da AWS revela que agentes de IA criam programas em Blender a partir de fotos, mas erram ao autoavaliar a geometria.
Resumo rápido
- Projeto LEGO-Anything usa agentes de IA para criar e editar programas no software Blender a partir de uma única foto.
- Avaliação pelo benchmark LEGO-Bench mostrou que modelos como o GPT-6 Astra entregam artefatos funcionais, mas falham na geometria.
- Extensão LEGO-Plugin substituiu o julgamento próprio dos agentes por medições concretas, aumentando a precisão de todos os modelos.
Entenda o contexto
Entenda o contexto: o projeto LEGO-Anything introduz o conceito de Image-to-Code, no qual um agente de inteligência artificial escreve instruções em código para construir e manipular ambientes 3D em softwares como o Blender. A abordagem busca transformar imagens estáticas em arquivos executáveis e editáveis, embora a precisão geométrica e a capacidade dos modelos de avaliarem o próprio trabalho ainda sejam gargalos em desenvolvimento.
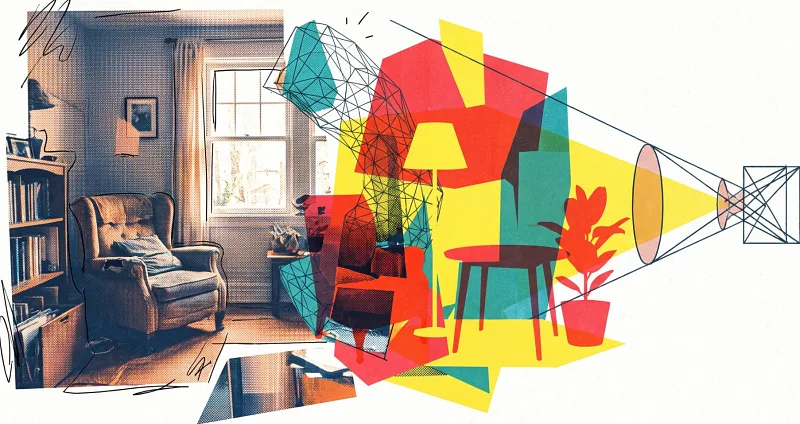
Pesquisadores da Universidade de Maryland e da AWS apresentaram o LEGO-Anything, um projeto que utiliza agentes de programação para reconstruir cenas em 3D totalmente editáveis a partir de uma única imagem. A abordagem, chamada de "Image-to-Code", faz com que o agente escreva e ajuste iterativamente um código para o software Blender até que o resultado corresponda à foto enviada.
Diferente de geradores que criam o objeto em uma única passagem, a técnica gera um programa executável. Isso permite inspecionar, alterar e consultar elementos explícitos da cena, como a posição da câmera, a iluminação, a geometria e os objetos presentes.
Benchmark revela limitações em autoavaliação geométrica
Para medir a eficácia desse processo, a equipe criou o LEGO-Bench, um conjunto de testes composto por 208 imagens de 104 ambientes internos e externos, utilizando 443 objetos registrados. As imagens de teste foram geradas a partir de ambientes simulados profissionais, o que garantiu uma referência geométrica exata e oculta para pontuação automática sem perder o aspecto visual natural.
A avaliação testou seis configurações do GPT. O modelo GPT-6 Astra apresentou o melhor desempenho geral, atingindo 53,4% de precisão em ambientes internos e 39,6% em externos. Quando o orçamento de raciocínio do modelo foi elevado, sua pontuação em um subconjunto de testes de escritórios subiu de 32,3% para 61,8%. No entanto, modelos mais fracos registraram marcas próximas de 15%.
Ao analisar os passos executados pelos agentes, os pesquisadores constataram que as falhas mais comuns envolvem tentativas iniciais ruins, revisões que desfazem progressos anteriores e uma incapacidade crônica de autoavaliação. Ao ter que comparar duas versões da mesma cena para indicar qual estava mais fiel à fotografia original, a taxa de acerto dos modelos ficou perto ou abaixo do nível do acaso. Na prática, o agente não consegue identificar se suas próprias alterações melhoraram ou pioraram a geometria.
Plugin melhora resultados e reduz erros
Com base nesse diagnóstico, os autores desenvolveram o LEGO-Plugin, uma extensão que não exige treinamento adicional. O recurso ancora a cena inicial na imagem de referência e substitui o julgamento interno do agente por medições concretas, protegendo os avanços já conquistados contra edições regressivas. A adição do plugin resultou em melhorias para todas as seis configurações testadas, com ganhos de até 62,7% nos modelos mais fracos.
Apesar do avanço, os pesquisadores destacam que as cenas geradas ainda não têm precisão suficiente para substituir modelos especializados em tarefas de visão computacional, como detecção de objetos, segmentação e estimativa de profundidade. Embora tenham produzido resultados funcionais sem treinamento extra, o desempenho em detecção de objetos atingiu cerca de metade da capacidade do modelo DINO, enquanto a lacuna para ferramentas especializadas como SAM 3 e Depth Anything 3 permaneceu mais ampla.
Referências
- Reportagem consultada: The Decoder
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!