Adobe Research e UC San Diego testam agente de IA para edição
O EditAgent combina ferramentas especializadas de edição com dados numéricos, mas consome dez vezes mais computação, segundo pesquisadores.
Resumo rápido
- Pesquisadores da Adobe Research e da UC San Diego apresentaram o EditAgent, sistema de IA que divide a edição de imagens em etapas e aciona ferramentas especializadas.
- O sistema utiliza estatísticas e recortes para avaliar os resultados, superando modelos dedicados de avaliação, embora exija cerca de dez vezes mais computação.
- Segundo o estudo, o agente produziu cerca de 26.000 exemplos de treinamento verificados, que aprimoraram modelos de edição ajustados com esses dados.
Entenda o contexto
Entenda o contexto: O EditAgent é um sistema experimental de inteligência artificial criado para automatizar a edição de imagens dividindo comandos complexos em etapas especializadas. A abordagem busca solucionar falhas frequentes de modelos gerais ao comparar edições por meio de métricas numéricas diretas nas imagens.
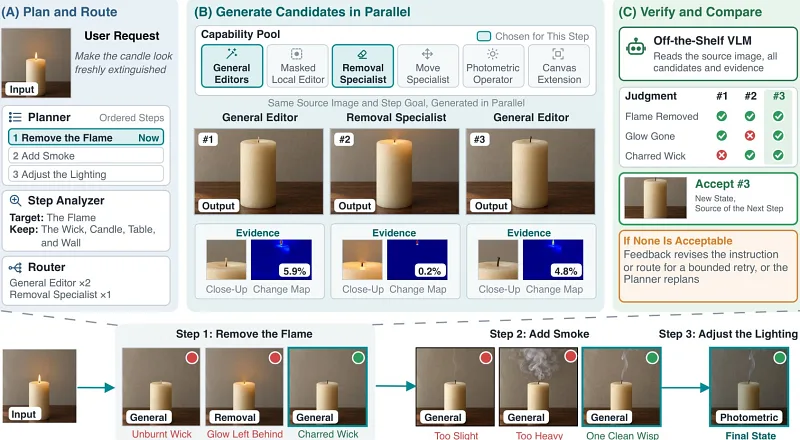
Pesquisadores da Adobe Research e da UC San Diego desenvolveram o EditAgent, um sistema de inteligência artificial voltado para a edição de imagens. Segundo artigo publicado pelos cientistas, o sistema divide solicitações complexas em etapas e combina um editor de uso geral com ferramentas especializadas para tarefas como nitidez, rotação e zoom.
Como o EditAgent estrutura as tarefas de edição?
Em um teste com 600 edições de imagem avaliadas às cegas por cinco profissionais, o editor geral Flux-2-Klein-9B não produziu um resultado aproveitável em 42,7% das vezes. As ferramentas especializadas resolveram aproximadamente dois terços dessas falhas. De acordo com o estudo, tentar repetidamente a mesma tarefa com o mesmo editor quase não trouxe melhorias.
A pesquisa também analisou se o agente obtém melhores resultados ao refinar imagens de forma iterativa ou ao gerar variantes em paralelo a partir do arquivo original. Como o processo iterativo acumula pequenos erros a cada rodada, os profissionais preferiram as variantes paralelas em 78,5% das comparações em que escolheram um lado, exigindo metade das passagens de avaliação.
Como é feita a avaliação dos resultados?
Durante a execução, um modelo de linguagem padrão compara as variantes geradas em uma única passagem. O modelo recebe um registro de verificação contendo um recorte em aproximação da área editada, um mapa de alterações e estatísticas numéricas de brilho e cor. Em um exemplo citado no artigo, o objetivo era clarear suavemente uma foto: os dados numéricos indicaram que o editor geral superexpos a imagem e alterou as cores para tons mais quentes, enquanto a ferramenta especializada manteve-se dentro das especificações.
Com o registro de verificação, todos os sete modelos de linguagem testados superaram os modelos treinados especificamente para avaliação de imagens, como o EditScore. Sem esses dados numéricos, nenhum dos modelos padrão igualou o desempenho do sistema ajustado. Na medição, o modelo Qwen3.8-27B selecionou um resultado considerado aproveitável pelos profissionais em 81,3% dos casos, contra 74,8% do EditScore-72B.
O agente também verifica se etapas posteriores anularam edições anteriores. O estudo exemplifica com a instrução de deixar entrar mais luz do dia, que acabou tornando limpa uma janela previamente fosqueada, conflito que foi identificado e corrigido pelo sistema.
Quais são os custos e as limitações do sistema?
De acordo com os pesquisadores, o EditAgent demonstrou melhorias nos editores Qwen-Image-Edit-2511 e Flux-2-Klein-9B em três benchmarks. Na medição EdiVal, a variante com o modelo Qwen em sua terceira rodada de edição superou os modelos comerciais Seedream 4.0 e GPT-Image-1.5. No entanto, o agente precisa de cerca de dez vezes mais capacidade computacional do que um único editor, e seu desempenho depende das ferramentas que estão conectadas a ele.
Como benefício adicional, a filtragem do agente produziu cerca de 26.000 exemplos de treinamento verificados, segundo o estudo. Editores ajustados com esses dados apresentaram melhor desempenho nos três testes, enquanto dados gerados diretamente pelo modelo FLUX reduziram o desempenho do próprio FLUX. Segundo os pesquisadores, essa geração de dados pode compensar o elevado custo computacional ao longo do tempo. Mais detalhes sobre a pesquisa foram relatados em cobertura do veículo The Decoder.
Referências
- Reportagem consultada: The Decoder
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!