Suno lança o recurso Speech para gerar narração e música de fundo
A Suno lançou o Speech em beta pública para web e celulares. A ferramenta gera vozes e faixas de música de fundo simultaneamente.
Resumo rápido
- A Suno lançou o recurso Speech em fase beta pública para a web e dispositivos móveis.
- A ferramenta gera vozes faladas e trilhas sonoras simultaneamente em uma única faixa de áudio.
- O recurso permite utilizar descrições em texto ou roteiros personalizados com duração de até 8 minutos.
Entenda o contexto
A Suno é uma plataforma focada na geração de música por meio de inteligência artificial. O termo conversão de texto em fala refere-se a sistemas que transformam textos escritos em áudio falado. A iniciativa da Suno busca diversificar a plataforma de criação sonora ao unir narração e trilha musical em uma única ferramenta.
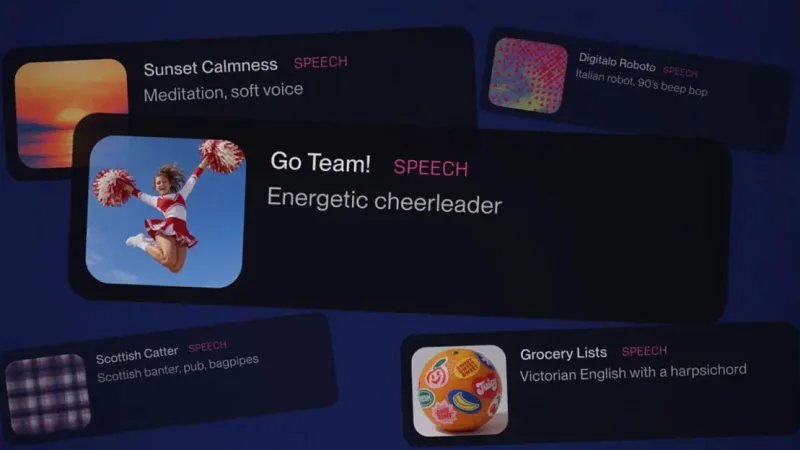
A plataforma Suno expandiu suas funcionalidades para além da criação musical e lançou o Speech, um novo recurso que gera vozes faladas a partir de roteiros ou descrições em texto. A novidade foi disponibilizada nesta sexta-feira, 2 de outubro de 2026, em versão beta pública para os sistemas web e móveis da empresa. O diferencial da tecnologia é a capacidade de gerar narrações e músicas de fundo de forma simultânea, unindo os dois elementos em uma única faixa sonora.
Segundo a empresa, o uso da trilha sonora de fundo é opcional, permitindo que os usuários desativem a música por meio de um botão caso queiram apenas o áudio da voz limpo. O diretor de produto da Suno, Jack Brody, afirmou no anúncio oficial que a música continuará no centro do desenvolvimento da empresa, mas definiu o Speech como o primeiro modelo de áudio capaz de gerar voz e música juntas de maneira coesa. O mercado de síntese de voz por inteligência artificial já conta com soluções de organizações como DeepMind, Adobe e ElevenLabs, mas a proposta da Suno é integrar a locução à sua plataforma musical.
Modos de criação e configurações do Speech
Para utilizar a funcionalidade, o usuário deve acessar a aba de criação e selecionar a opção Speech. A ferramenta conta com dois modos de operação: o Simple, no qual se descreve o conteúdo desejado por meio de um campo de texto, e o Advanced, voltado para a inserção de roteiros personalizados. Nas configurações avançadas, é possível ajustar parâmetros como o gênero da voz artificial, o estilo de fala e o nível de variação gerado pelo modelo a cada execução.
As gerações realizadas pelo Speech têm uma duração máxima de cerca de oito minutos. A Suno reconheceu que o recurso ainda não está perfeito e continuará recebendo aprimoramentos com base no retorno do público. De acordo com Brody, é esperado que ocorram falhas durante a fase de testes, como variações inesperadas em sotaques regionais ou pausas dramáticas excessivas ao longo dos áudios.
Referências
- Reportagem consultada: The Verge — IA
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!