Nvidia lança modelo Kumo Tabular para análise de dados em tabelas
Nvidia lança o Kumo Tabular, modelo base aberto pré-treinado em dados artificiais para predições diretas em tabelas sem necessidade de ajustes.
Resumo rápido
- A Nvidia disponibilizou o Kumo Tabular, modelo base aberto para predições em dados tabulares no Hugging Face.
- O sistema executa tarefas de classificação e regressão em uma única passagem, sem precisar de ajustes ou treino extra.
- Desenvolvido exclusivamente com dados artificiais, o modelo conta com três tamanhos entre 28M e 215M de parâmetros.
Entenda o contexto
Dados tabulares, organizados em colunas e linhas como planilhas e bancos de dados, formam a base de sistemas corporativos para tarefas como previsão de demanda e análise de risco. O uso de modelos base do tipo Transformer para esses dados busca aplicar a capacidade de aprendizado direto no contexto, reduzindo a necessidade de criar e treinar um modelo do zero para cada novo problema.
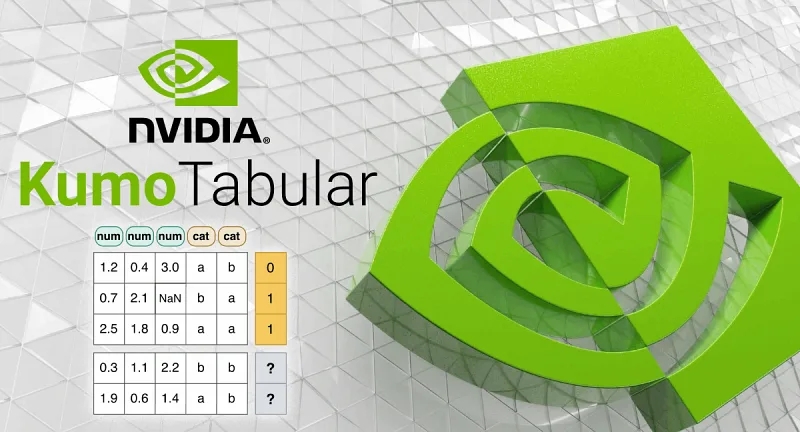
A Nvidia anunciou a disponibilização do NVIDIA Kumo Tabular no Hugging Face. Integrante da coleção de modelos NVIDIA Kumo Structured, a novidade é apresentada como um modelo base aberto voltado para a previsão em dados tabulares, englobando tarefas de classificação e de regressão.
Predição direta sem treinamento prévio
Diferentemente dos métodos tradicionais baseados em árvores de decisão impulsionadas por gradiente, que exigem coleta de rótulos e ajuste de hiperparâmetros a cada nova tarefa, o Kumo Tabular aplica o aprendizado no contexto (in-context learning). A partir de uma tabela com linhas rotuladas fornecida no contexto, o modelo calcula as probabilidades de classe ou estimativas numéricas para novas linhas em uma única passagem, sem a necessidade de treinamento, ajustes finos (tuning) ou engenharia de recursos.
A arquitetura do Kumo Tabular é baseada em Transformer e utiliza um sistema de atenção focado na estrutura das tabelas, dividindo o processo em etapas de incorporação de células (cell embedding), incorporação de linhas (row embedding) e aprendizado no contexto. Para evitar que a atenção se perca em tabelas muito grandes, a Nvidia implementou uma temperatura de atenção ajustável, permitindo manter o foco à medida que o número de linhas ou colunas aumenta.
Treinamento com dados artificiais e versões
Segundo a publicação da empresa, o Kumo Tabular foi pré-treinado exclusivamente com dados artificiais gerados a partir de Modelos Causais Estruturais (SCM). O gerador procedural produziu milhões de tabelas sintéticas simulando imperfeições do mundo real, como valores ausentes, dados truncados e colunas categóricas com múltiplos níveis. Nas fases de treinamento, os modelos operaram em tabelas de até 60.000 linhas e até 100 colunas. A empresa treinou modelos separados para classificação e regressão.
O modelo está disponível em três tamanhos, variando de 28 milhões a 215 milhões de parâmetros, que juntos visualizaram entre 35 e 137 milhões de tabelas sintéticas durante o processo de desenvolvimento. A Nvidia afirma que o sistema alcançou a primeira colocação em benchmarks do setor, incluindo TabArena, BeyondArena, TALENT e ScoringBench.
Disponibilidade e licença
O NVIDIA Kumo Tabular foi disponibilizado publicamente sob a licença OpenMDW-1.1, que permite o uso comercial. O código do modelo pode ser acessado por meio de repositório no GitHub e sua biblioteca de execução é de código aberto. A empresa informou que pretende disponibilizar em breve suas receitas de treinamento e os geradores de dados artificiais utilizados no projeto.
Referências
- Fonte consultada: Hugging Face — Blog
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!