Liquid AI lança modelos de decisão abertos d1 para dispositivos de borda
A Liquid AI lançou os modelos de decisão open d1 com pesos abertos no Hugging Face, com foco em alta velocidade para execução local e multimodal.
Resumo rápido
- Liquid AI disponibiliza no Hugging Face os modelos de decisão open d1 com pesos abertos para uso em borda.
- O modelo d1-3B opera em uma única passagem direta sem gerar tokens sequenciais para obter respostas rápidas.
- Avaliações mostram respostas a perguntas em até 16 ms em hardware especializado como o NVIDIA Jetson AGX Thor.
Entenda o contexto
Modelos de decisão são sistemas focados em classificar ou selecionar respostas estruturadas sem realizar a geração sequencial de texto ponto a ponto. A execução em borda permite processar dados diretamente no hardware local, como chips integrados, reduzindo a dependência de servidores na nuvem e diminuindo o tempo de latência.
A Liquid AI anunciou o lançamento da família open d1, composta pelos modelos de decisão multimodais de pesos abertos d1-3B e d1-omni-600M, voltados para execução em dispositivos de borda. As opções já estão disponíveis para download na plataforma Hugging Face.
Arquitetura focada em velocidade e decisão direta
Diferentemente dos modelos gerativos tradicionais, os sistemas da linha d1 não geram tokens sequencialmente. A arquitetura foi desenvolvida para responder em uma única passagem direta (conhecida como single forward pass), com o objetivo de entregar decisões estruturadas de maneira rápida. A publicação técnica detalha que as duas opções partem de bases distintas das Liquid Foundation Models (LFMs).
O modelo d1-3B é derivado do LFM2.5-VL-3B, um modelo de linguagem e visão do tipo decoder-only que aceita entradas combinadas de texto e imagem. Já o d1-omni-600M utiliza como base o codificador bidirecional LFM2.5-Encoder-350M, ao qual foram adicionados codificadores de visão e áudio para processar tanto texto e imagem quanto texto e áudio. Segundo a desenvolvedora, o d1-omni-600M encontra-se atualmente em uma fase inicial de pesquisa e segue em desenvolvimento.
Desempenho em benchmarks e tempo de resposta
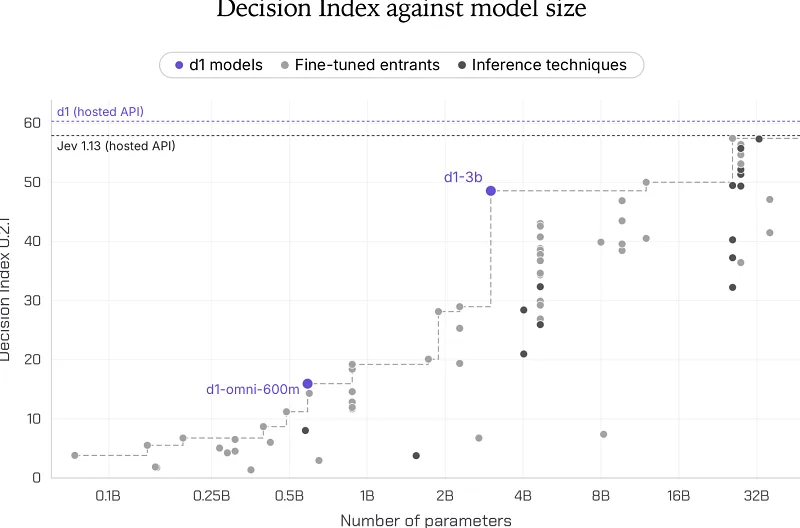
Nos testes divulgados, o d1-3B alcançou a pontuação 48,57 no teste Decision Index 0.2.1, superando outros modelos de até 9 bilhões de parâmetros listados pela empresa, como o Strands Decider 2B. Em uma avaliação composta por sete conjuntos de dados públicos — que envolvem compreensão de texto, detecção de toxicidade, classificação de intenção e perguntas e respostas médicas —, o d1-3B obteve uma pontuação média de 82,9. O d1-omni-600M registrou média de 78,4 nos mesmos testes.
Em testes de inferência realizados em parceria com a NVIDIA, o d1-3B registrou tempo de resposta inferior a 50 milissegundos por pergunta em todos os dispositivos de borda avaliados. No hardware NVIDIA Jetson AGX Thor, uma pergunta individual levou 16 milissegundos para ser processada, enquanto no Jetson Orin Nano o tempo foi de 50 milissegundos. Em placas gráficas como a NVIDIA GeForce RTX 4090, a resposta ocorreu em menos de 10 milissegundos, com o processamento de imagens de 384 pixels concluído em menos de 18 milissegundos. A empresa informou que não publicou métricas de velocidade para o d1-omni-600M devido ao seu estágio preliminar de desenvolvimento.
Referências
- Fonte consultada: Hugging Face — Blog
Links para conferência: não indicam endosso das fontes ao conteúdo do portal.
Gostou? Compartilhe:
Comentários 0
Ninguém comentou ainda. Seja o primeiro!